Monitoraggio LMS: vedere cosa sta succedendo alla piattaforma prima che il problema diventi un disservizio.
Monitoriamo disponibilità, tempi di risposta, CPU, RAM, PHP, database, Redis, Cron, MoodleData, backup ed errori applicativi per individuare anomalie e degradamenti.
Un server online e una piattaforma sana non sono la stessa cosa.
Moodle può essere raggiungibile mentre PHP è in coda, il database risponde lentamente, Redis è in errore o il filesystem sta esaurendo spazio.
Dal DNS al database, ogni componente contribuisce all’esperienza che vede l’utente.
Non controlliamo soltanto “risponde / non risponde”: osserviamo anche come cambia il tempo di risposta.
Uptime, status HTTP, timeout e degrado progressivo aiutano a distinguere indisponibilità totale e servizio ancora online ma lento.
CPU, load, RAM, swap, filesystem e I/O descrivono una parte del problema, non tutta la diagnosi.
Le metriche infrastrutturali vengono lette insieme al comportamento applicativo per evitare conclusioni basate su un singolo numero.
Approfondisci Server Moodle.
Un server può avere CPU libera e utenti in attesa perché il collo di bottiglia è altrove.
Processi attivi, processi disponibili, code, memoria, errori e tempi aiutano a capire se PHP sta servendo le richieste o le sta accumulando.
Moodle può aspettare il database molto più a lungo di quanto impieghi PHP a costruire la pagina.
Connessioni, query lente, lock, carico, dimensione e I/O devono essere correlati con il momento in cui gli utenti percepiscono il problema.
Approfondisci Moodle lento.
Disponibilità e memoria di Redis possono incidere su cache e sessioni quando viene usato nell’architettura.
Connessioni, errori, memoria ed eviction dove rilevante aiutano a capire se Redis sta svolgendo correttamente il proprio ruolo.
Approfondisci Redis Moodle.
“Cron eseguito” non significa automaticamente “tutti i task completati”.
Ritardi, task falliti, code e processi che durano troppo devono essere osservati per capire se le automazioni Moodle stanno realmente completando il lavoro.
Approfondisci Moodle Cron.
Spazio, crescita e I/O possono anticipare problemi molto prima che il filesystem si riempia.
Trend e soglie permettono di pianificare capacità e interventi sullo storage senza aspettare l’errore finale.
Approfondisci MoodleData.
Un backup non monitorato può smettere di funzionare senza che nessuno se ne accorga.
Ultimo backup valido, esito, durata, dimensione, repository e spazio disponibile devono essere verificabili.
Approfondisci Backup LMS.
500, 502, 503 e 504 sono sintomi: il monitoraggio deve aiutarci a correlare l’errore con la causa tecnica.
PHP, web server, database, rete o integrazioni possono produrre errori simili con cause completamente diverse.
Un certificato scaduto può rendere inutilizzabile un servizio tecnicamente sano.
Scadenze e validità dei certificati rientrano nei controlli operativi quando sono parte dell’infrastruttura gestita.
LMS eLearning moderni dipendono spesso da componenti che vivono fuori dal server Moodle.
API, SSO, CRM, email e altri servizi esterni possono essere monitorati per distinguere un problema Moodle da un problema di dipendenza.
Le metriche sono più utili quando sappiamo cosa stavano facendo gli utenti nel momento del picco.
Correlare carico e comportamento permette di capire se il rallentamento nasce da login, SCORM, quiz, report o altro.
Approfondisci Moodle e utenti contemporanei.
Quando lo SCORM è parte critica del servizio, errori e degrado vanno correlati con piattaforma, storage e tracking.
Monitoraggio infrastrutturale e analisi applicativa aiutano a distinguere problemi del pacchetto da problemi dell’ambiente Moodle.
Approfondisci Moodle SCORM.
Dashboard e report possono essere sia strumenti di controllo sia sorgenti di carico.
Query, tempi e picchi di utilizzo aiutano a capire quando la reportistica sta incidendo sull’esperienza degli utenti.
Approfondisci Reportistica eLearning.
Tre strumenti diversi per tre domande diverse.
Cosa sta succedendo adesso?
Metriche e stato corrente aiutano a vedere salute e degrado.
Cosa è successo?
I log aiutano a ricostruire errori ed eventi nel tempo.
Quando serve intervenire?
Gli alert trasformano segnali in condizioni che richiedono attenzione.
Un alert utile deve indicare una condizione che richiede una decisione, non semplicemente una metrica che si è mossa.
Warning, critical, escalation, deduplicazione e finestre temporali aiutano a ridurre il rumore e a distinguere un’anomalia da un incidente reale.
Non tutte le anomalie sono incidenti: prima definiamo cosa significa “normale” per quella piattaforma.
Una baseline permette di riconoscere deviazioni significative senza reagire a ogni breve variazione di CPU, RAM o latenza.
Il monitoraggio più utile non dice soltanto che il disco è pieno. Può mostrare che sta crescendo verso la saturazione.
MoodleData, database, storage e carico possono essere osservati nel tempo per programmare capacità prima del problema.
I dati reali di utilizzo diventano input per dimensionare crescita, picchi e infrastruttura futura.
Monitoraggio e capacity planning si alimentano a vicenda: misuriamo il comportamento reale e lo confrontiamo con la crescita prevista.
Approfondisci Requisiti Server Moodle.
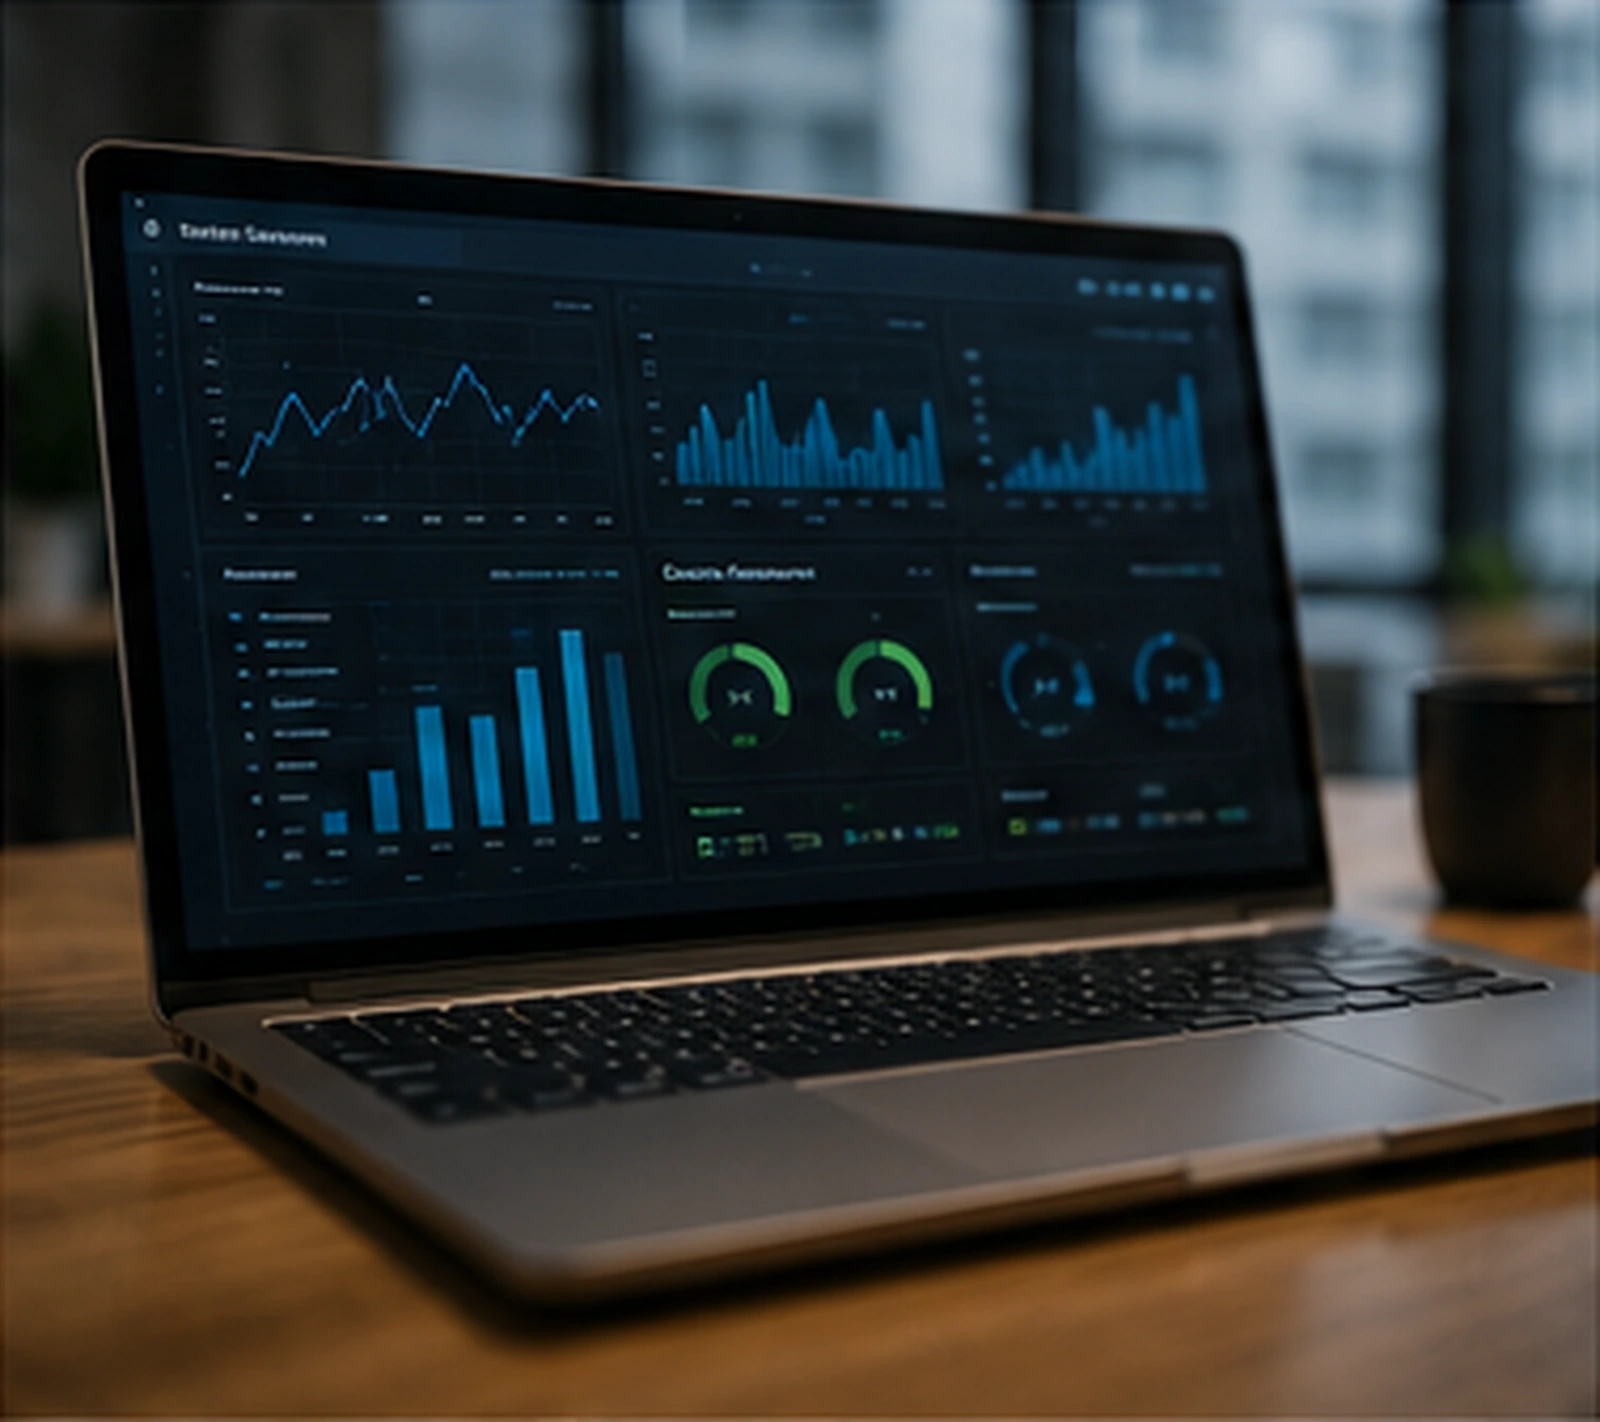
Il monitoring non sostituisce l’ottimizzazione, ma ci dice dove iniziare a cercare.
Quando un tempo di risposta peggiora, possiamo correlare PHP, database, storage, Redis e traffico prima di modificare l’infrastruttura.
Approfondisci Ottimizzazione Moodle.
In un ambiente HA ogni nodo e ogni componente condiviso deve essere osservabile.
Load balancer, web node, Redis, database e storage possono essere sani singolarmente ma degradare come sistema.
Approfondisci High Availability LMS.
Il monitoraggio può rilevare l’incidente; il Disaster Recovery definisce come ripartire quando l’ambiente primario non basta più.
Approfondisci Disaster Recovery LMS.
Login anomali, errori ripetuti e servizi inattesi possono diventare segnali utili, ma il monitoraggio non sostituisce un audit di sicurezza.
Logging e metriche aiutano la detection operativa; hardening, controllo accessi e remediation rimangono attività distinte.
Approfondisci Sicurezza LMS.
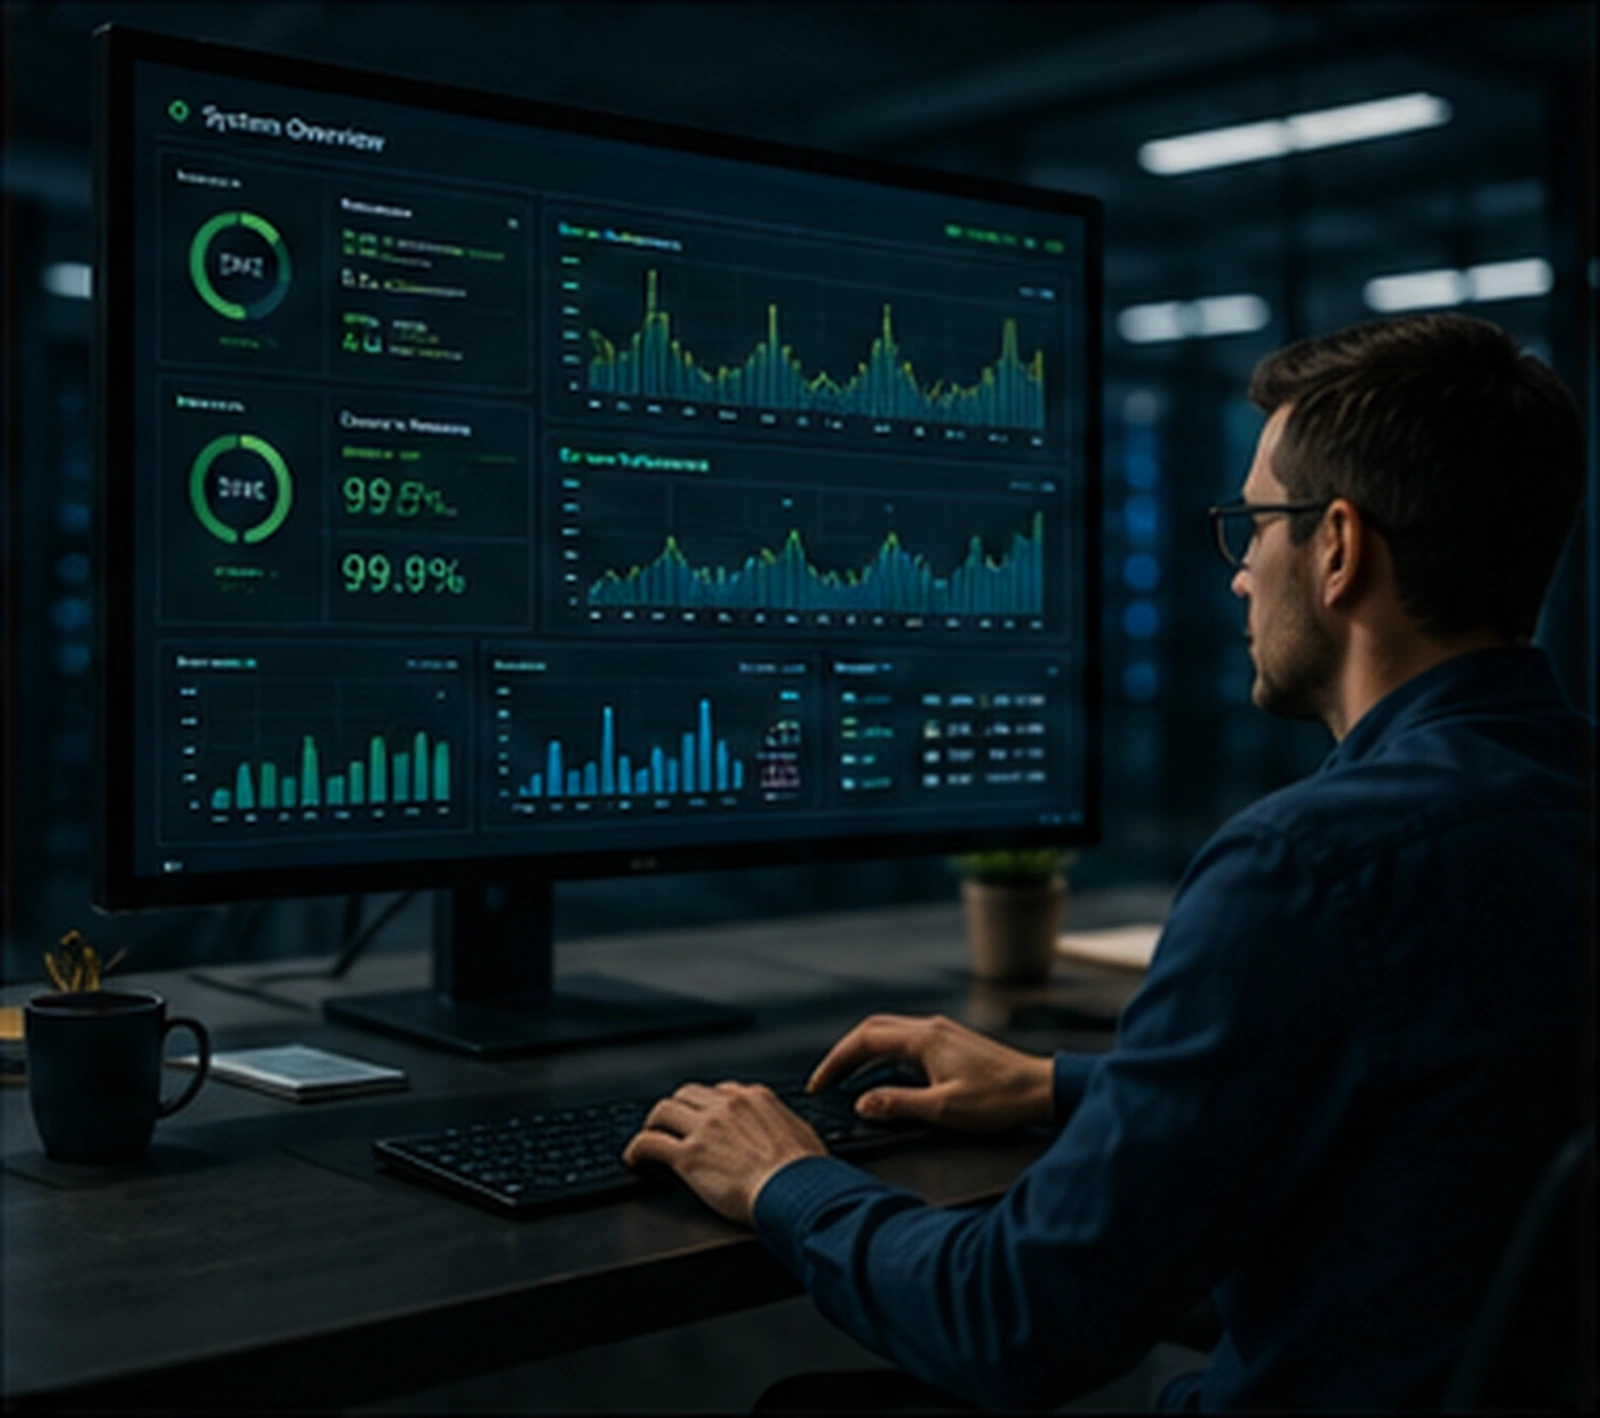
La dashboard deve mostrare ciò che serve a capire lo stato del servizio, non riempire lo schermo di metriche.
Quando previsto nel progetto possiamo centralizzare stato LMS, CPU, RAM, storage, database, Redis, backup, uptime, alert e trend in un pannello operativo coerente con l’infrastruttura realmente monitorata.
Non monitoriamo tutto perché possiamo. Monitoriamo ciò che permette di capire se il servizio sta degradando e perché.
Quando costruisco un sistema di monitoraggio voglio che risponda a tre domande.
Il servizio funziona? Sta peggiorando? Se qualcosa non va, dove devo guardare per primo?
Cosa dicono i clienti che lavorano con Atlas Learning.
Le recensioni vengono mostrate dinamicamente tramite Trustindex.


Domande frequenti su metriche, alert e osservabilità.
Cos’è il monitoraggio Moodle?
È l’osservazione di disponibilità, performance, errori e componenti tecnici per capire se la piattaforma sta funzionando correttamente.
Perché monitorare un LMS?
Per individuare degradi e anomalie prima che diventino indisponibilità o problemi diffusi per gli utenti.
Cosa significa uptime?
Indica la disponibilità del servizio, ma non descrive da solo tempi di risposta o salute dei componenti interni.
Quali metriche sono più importanti?
Dipende dall’architettura: CPU, RAM, PHP, database, Redis, storage, tempi di risposta, errori, backup e Cron possono essere rilevanti.
Monitorate anche MoodleData?
Sì quando rientra nel perimetro: spazio, crescita e I/O possono anticipare problemi di capacità o performance.
Monitorate il database?
Sì nel perimetro concordato, osservando connessioni, carico, query lente, lock e altri segnali utili.
Monitorate il Cron Moodle?
Sì, quando richiesto possiamo verificare esecuzione, ritardi e task che falliscono o si accumulano.
Cos’è un alert?
È una notifica generata quando una condizione supera il livello che richiede attenzione o verifica.
Come riducete i falsi positivi?
Definendo baseline, finestre temporali e condizioni che distinguano picchi normali da anomalie persistenti.
Fornite una dashboard dedicata?
Quando prevista dal progetto possiamo centralizzare le metriche disponibili in un pannello operativo personalizzato.
Monitorate anche i backup?
Sì, verificando nel perimetro concordato esito, ultimo backup valido, durata, repository e spazio disponibile.
È possibile monitorare una piattaforma esistente?
Sì. Partiamo dall’architettura attuale e dagli accessi disponibili per definire cosa può essere osservato.
Cosa succede quando scatta un alert critico?
Dipende dal servizio contrattualizzato: l’alert può attivare verifica, escalation o intervento secondo le procedure concordate.
Fornite report periodici?
Possono essere previsti report o analisi periodiche su trend, capacità ed eventi rilevanti nel perimetro del servizio.
Monitorate servizi esterni e API?
Sì quando sono dipendenze importanti del servizio e tecnicamente osservabili.
Monitoring e logging sono la stessa cosa?
No. Il monitoring mostra stato e metriche; i log aiutano a ricostruire eventi e possibili cause.
Il monitoraggio migliora la sicurezza?
Può aiutare la detection di anomalie, ma non sostituisce hardening, audit o gestione delle vulnerabilità.
Il monitoraggio rende Moodle più veloce?
No direttamente: permette però di individuare dove il servizio perde tempo e guidare l’ottimizzazione.
Qual è oggi il problema che vorresti conoscere prima che venga segnalato dagli utenti?
Quali componenti sono già monitorati? Quando Moodle rallenta o smette di funzionare, quali dati hai oggi per capire perché? Da queste risposte iniziamo il progetto.